
Model Detayları
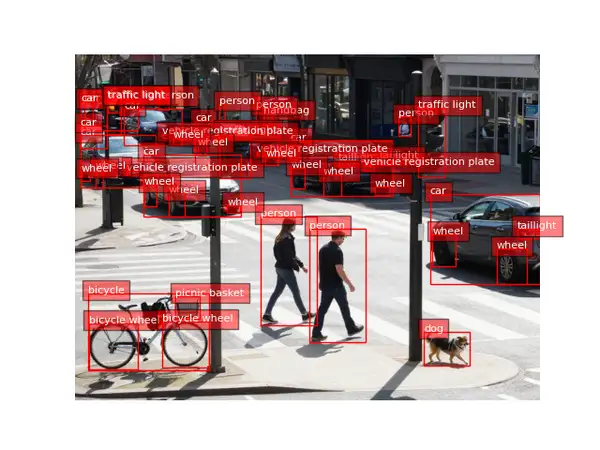
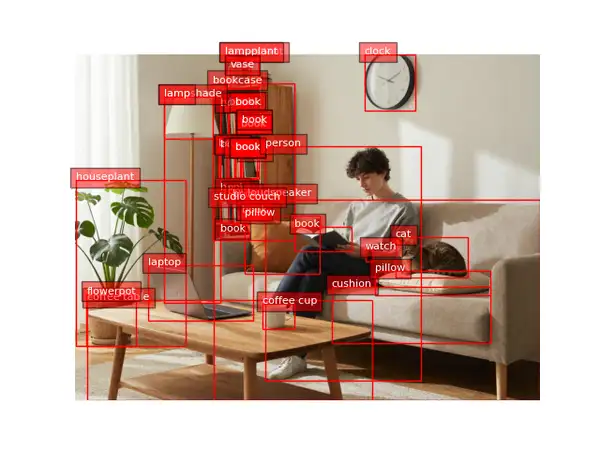
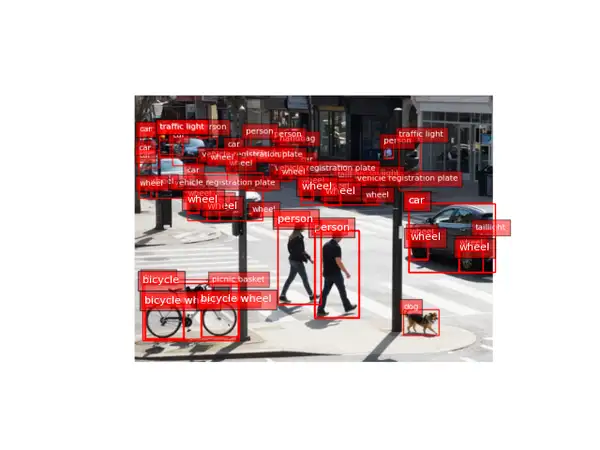
Florence-2 Large Object Detection, bir fotoğraftaki nesneleri bulur ve aynı görseli, her tespitin etrafına etiketli bir bounding box çizilmiş olarak döndürür. Tek bir görsel URL’si verin; bulduğu her nesneyi — insanları, araçları, hayvanları ve yaygın gündelik eşyaları — işaretleyen, her kutuya bir kategori etiketi yazılmış bir görsel alırsınız. Ne prompt ne de ince ayar gerekir: bir görsel girer, işaretlenmiş bir görsel çıkar. Microsoft’un Florence-2 vision-language temel modeli üzerine kuruludur ve geniş bir open vocabulary kapsamındaki gündelik nesne kategorilerini tek geçişte tanır; bu da onu bir görselde ne olduğunu hızlıca görmenin ve doğrulamanın pratik bir yolu yapar.
## En uygun olduğu işler - İnceleme ya da QA için bir fotoğrafta tespit edilen her nesneyi etiketli kutularla işaretlemek - Bir sahnede neler olduğunun hızlı bir görsel dökümünü çıkarmak (insanlar, arabalar, hayvanlar, nesneler) - Bir veri setinde tespit kapsamının sağlamasını yapmak için önce/sonra tespit overlay’leri üretmek - Ham koordinatlardan çok çizilmiş, insanın okuyabileceği bir sonucun önemli olduğu hafif sahne anlama işleri
## Şu durumlarda başka bir model seçin - Nesne tespiti yerine görseldeki metni okumak ya da yazıya dökmek istiyorsanız — bir OCR modeli kullanın - Kutular yerine sahneyi anlatan yazılı bir açıklama istiyorsanız — bir görsel açıklama (image captioning) modeli kullanın - Yalnızca metinle adını verdiğiniz belirli bir şeyi tespit etmek istiyorsanız — bir open-vocabulary / grounding dedektörü kullanın - Nesneleri kutular yerine piksel maskeleriyle ayırmak istiyorsanız — bir görsel segmentasyon modeli kullanın
## İpuçları - Net ve makul ölçüde yüksek çözünürlüklü bir fotoğraf verin; küçük ya da büyük kısmı örtülü nesneler, piksel arttıkça daha kolay tespit edilir. - Dönen görsel, kutuların ve etiketlerin zaten çizili olduğu standart bir PNG’dir; doğrudan gösterebilir ya da orijinaliyle karşılaştırabilirsiniz. - Ayarlanacak eşik ya da prompt yoktur — aynı görsel üzerindeki her çalıştırma deterministiktir.
## Sınırlamalar - Yaygın kategorilerden oluşan sabit bir open vocabulary üzerinden tespit yapar; nadir ya da alana özgü nesneler atlanabilir veya yanlış etiketlenebilir. - Çok küçük, bulanık ya da üst üste binen nesneler birleştirilebilir ya da atlanabilir.
ModelRunner JavaScript client ile çalıştırmak için: ```js import { modelrunner } from "@modelrunner/client";
const result = await modelrunner.subscribe("microsoft/florence-2-large/object-detection", { input: { image_url: "https://media.modelrunner.ai/example-scene.png", }, }); ```