
Ana içeriğe geç
microsoft avatarı

Florence-2 Large Dense Region Caption API

microsoft/florence-2-large/dense-region-caption

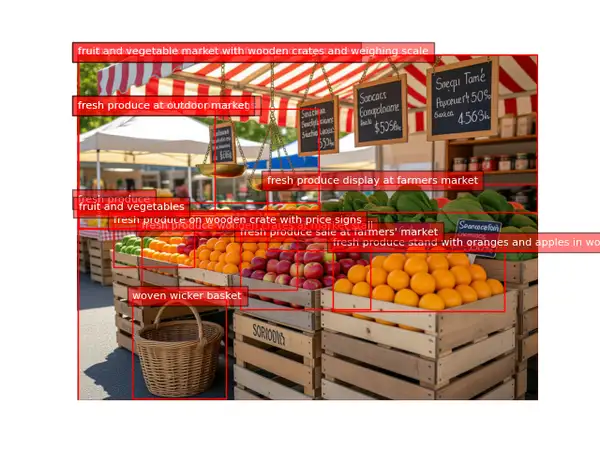
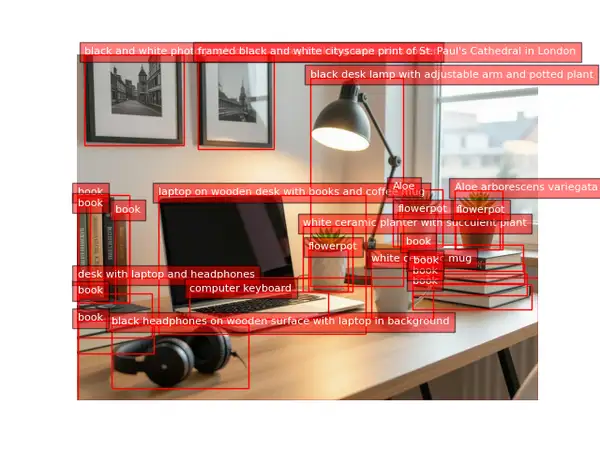
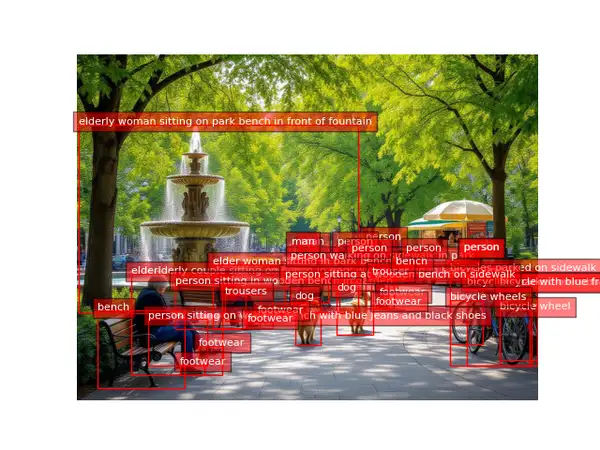
Bir fotoğraftaki belirgin bölgeleri tespit edin ve işaretlenmiş bir görsel alın: her bölge kutuya alınır ve içeriğini anlatan kısa, doğal dilde bir açıklamayla etiketlenir.

0.01

Model girdisi

Input

URL of the image to detect and caption regions in.

You need to be logged in to run this model and view results.
Log in

Model çıktısı

Output

Loading
Generated in 3.68 seconds
Logs (1 lines)

Örnek istekler

Örnekler

Example output 1Example output 2Example output 3

Florence-2 Large Dense Region Caption API

Florence-2 Large Dense Region Caption is a image-to-image AI model by microsoft. On ModelRunner it runs through a REST API or via MCP from any AI assistant, at $0.01 per image.

POST https://queue.modelrunner.run/microsoft/florence-2-large/dense-region-caption

cURL

# Submit a request to the queue. Input fields go at the top level of the
# body. The optional reserved "metadata" object holds your own flat string
# tags — stored on the request, never sent to the model; filter later with
# GET https://queue.modelrunner.run/requests?metadata=<url-encoded JSON>.
curl -X POST https://queue.modelrunner.run/microsoft/florence-2-large/dense-region-caption \
  -H "Authorization: Key $MRUN_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "image_url": "https://media.modelrunner.ai/uFX7lOTnPQmi3Cf9PSjrb.jpeg",
    "metadata": {
      "project": "my-project"
    }
  }'
# → { "request_id": "...", "status_url": "...", "response_url": "..." }

# Poll status_url until "COMPLETED", then fetch the result
curl "https://queue.modelrunner.run/microsoft/florence-2-large/dense-region-caption/requests/$REQUEST_ID/status" \
  -H "Authorization: Key $MRUN_API_KEY"
curl "https://queue.modelrunner.run/microsoft/florence-2-large/dense-region-caption/requests/$REQUEST_ID" \
  -H "Authorization: Key $MRUN_API_KEY"

JavaScript

import { modelrunner } from "@modelrunner/client";

const result = await modelrunner.subscribe("microsoft/florence-2-large/dense-region-caption", {
  input: {
    "image_url": "https://media.modelrunner.ai/uFX7lOTnPQmi3Cf9PSjrb.jpeg"
  },
});
console.log(result);

Python

import os
import requests

headers = {"Authorization": f"Key {os.environ['MRUN_API_KEY']}"}

submitted = requests.post(
    "https://queue.modelrunner.run/microsoft/florence-2-large/dense-region-caption",
    headers=headers,
    json={
      "image_url": "https://media.modelrunner.ai/uFX7lOTnPQmi3Cf9PSjrb.jpeg"
    },
).json()

# Poll submitted["status_url"] until "COMPLETED", then:
result = requests.get(submitted["response_url"], headers=headers).json()

Input parameters

Input parameters of Florence-2 Large Dense Region Caption
NameTypeRequiredDescription
image_urlstring (uri)yesURL of the image to detect and caption regions in.

Machine-readable: OpenAPI schema · llms.txt

Use Florence-2 Large Dense Region Caption from Claude & Cursor (MCP)

Point Claude Code, Claude Desktop, Cursor, or any MCP client at the ModelRunner MCP server and Florence-2 Large Dense Region Caption becomes a tool your assistant can call directly — it authorizes via OAuth (no API key in config) and runs this model with the run_model tool using the endpoint microsoft/florence-2-large/dense-region-caption.

MCP client config (Claude Desktop, Cursor)

{
  "mcpServers": {
    "modelrunner": {
      "command": "npx",
      "args": ["-y", "mcp-remote", "https://mcp.modelrunner.run/mcp"]
    }
  }
}

Claude Code

claude mcp add --transport http modelrunner https://mcp.modelrunner.run/mcp

Then ask your assistant, for example: “Run microsoft/florence-2-large/dense-region-caption on ModelRunner to generate image”. MCP setup guide.

Model Detayları

Model Detayları

Florence-2 Large Dense Region Caption, bir fotoğrafın tamamında belirgin bölgeleri arar ve her birine doğal dilde kısa bir açıklama yazar; her bölgenin etiketli bir kutu olarak çizildiği aynı görseli döndürür. Bir görsel URL’si verin; her bölgenin sade kelimelerle tarif edildiği işaretlenmiş bir görsel alırsınız — "wooden door with glass window on storefront", "person", "car" — ve yanında bölge başına yapılandırılmış sonuçlar gelir (her kutunun konumu ve açıklaması). Ne prompt ne de ince ayar gerekir: bir görsel girer, işaretlenmiş bir görsel çıkar. Microsoft’un Florence-2 vision-language temel modeli üzerine kuruludur ve nesne tespiti ile görselin bütününü açıklama arasında bir yerde durur: kutu başına tek kelimelik bir sınıf ya da tüm sahne için tek bir açıklama yerine, tek geçişte bölge düzeyinde yoğun bir açıklama seti üretir.

## En uygun olduğu işler - Bir fotoğrafı, her biri tarif edici bir açıklama taşıyan bölge kutularıyla yoğun biçimde işaretlemek - Bir bölgenin hem neyi gösterdiğini hem de nerede olduğunu bilmeniz gereken grounded bölge açıklamaları - Yalın nesne sınıfı etiketlerinin ötesinde, bir sahnenin zengin ve insanın okuyabileceği bir dökümünü çıkarmak - Bir sahnenin bölge bölge nasıl tarif edildiğini incelemek için önce/sonra overlay’leri üretmek

## Şu durumlarda başka bir model seçin - Tarif edici açıklamalar yerine yalnızca tek kelimelik nesne sınıfı etiketleri istiyorsanız — bir nesne tespiti modeli kullanın - Görseldeki metni okumak ya da yazıya dökmek istiyorsanız — bir OCR / metin tanıma modeli kullanın - Bölge başına açıklamalar yerine görselin tamamı için tek bir açıklama istiyorsanız — bir görsel açıklama (image captioning) modeli kullanın - Kutular yerine piksel hassasiyetinde maskeler istiyorsanız — bir görsel segmentasyon modeli kullanın

## İpuçları - Net ve makul ölçüde yüksek çözünürlüklü bir fotoğraf verin; piksel arttıkça hem daha fazla bölge çıkar hem de bölgeler daha iyi tarif edilir. - Dönen görsel, bölge kutularının ve açıklama etiketlerinin zaten çizili olduğu standart bir PNG’dir; doğrudan gösterebilir ya da orijinaliyle karşılaştırabilirsiniz. - Bölge açıklamaları, bölgeye göre tarif edici ifadelerle kısa sınıf adlarını karıştırır — aynı sonuçta ikisini birden görmeyi bekleyin. - Ayarlanacak eşik ya da prompt yoktur — aynı görsel üzerindeki her çalıştırma deterministiktir.

## Sınırlamalar - Açıklamalar kısa ve yaklaşıktır; ince nitelikler (tam renk, adet, marka) yanlış olabilir ya da atlanabilir. - Çok küçük, bulanık ya da üst üste binen bölgeler birleştirilebilir, atlanabilir ya da kabaca tarif edilebilir. - Kapsamı model belirler, eksiksiz değildir — bazı bölgeler açıklamasız kalabilir.

ModelRunner JavaScript client ile çalıştırmak için: ```js import { modelrunner } from "@modelrunner/client";

const result = await modelrunner.subscribe("microsoft/florence-2-large/dense-region-caption", { input: { image_url: "https://media.modelrunner.ai/example-storefront-scene.png", }, }); ```