
Model Detayları
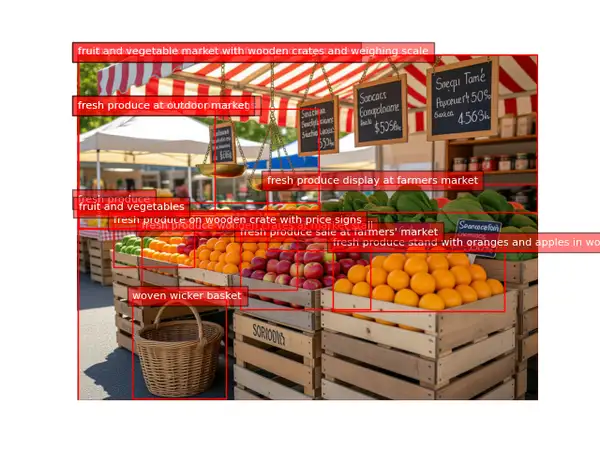
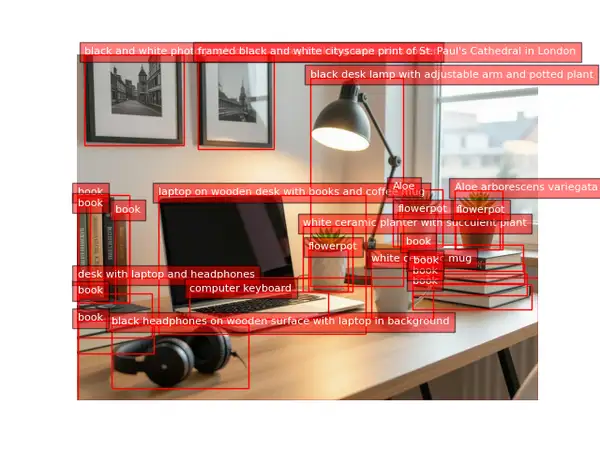
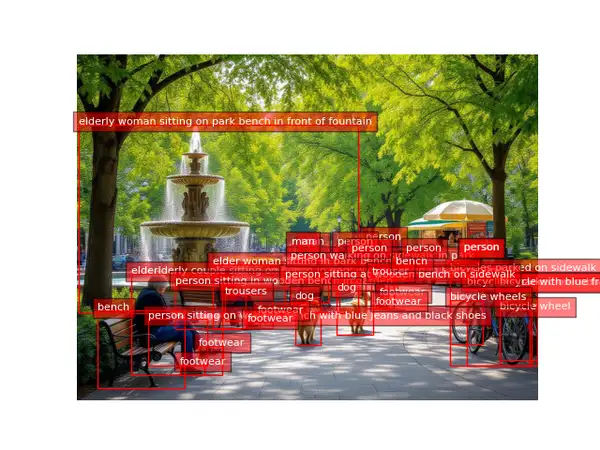
Florence-2 Large Dense Region Caption, bir fotoğrafın tamamında belirgin bölgeleri arar ve her birine doğal dilde kısa bir açıklama yazar; her bölgenin etiketli bir kutu olarak çizildiği aynı görseli döndürür. Bir görsel URL’si verin; her bölgenin sade kelimelerle tarif edildiği işaretlenmiş bir görsel alırsınız — "wooden door with glass window on storefront", "person", "car" — ve yanında bölge başına yapılandırılmış sonuçlar gelir (her kutunun konumu ve açıklaması). Ne prompt ne de ince ayar gerekir: bir görsel girer, işaretlenmiş bir görsel çıkar. Microsoft’un Florence-2 vision-language temel modeli üzerine kuruludur ve nesne tespiti ile görselin bütününü açıklama arasında bir yerde durur: kutu başına tek kelimelik bir sınıf ya da tüm sahne için tek bir açıklama yerine, tek geçişte bölge düzeyinde yoğun bir açıklama seti üretir.
## En uygun olduğu işler - Bir fotoğrafı, her biri tarif edici bir açıklama taşıyan bölge kutularıyla yoğun biçimde işaretlemek - Bir bölgenin hem neyi gösterdiğini hem de nerede olduğunu bilmeniz gereken grounded bölge açıklamaları - Yalın nesne sınıfı etiketlerinin ötesinde, bir sahnenin zengin ve insanın okuyabileceği bir dökümünü çıkarmak - Bir sahnenin bölge bölge nasıl tarif edildiğini incelemek için önce/sonra overlay’leri üretmek
## Şu durumlarda başka bir model seçin - Tarif edici açıklamalar yerine yalnızca tek kelimelik nesne sınıfı etiketleri istiyorsanız — bir nesne tespiti modeli kullanın - Görseldeki metni okumak ya da yazıya dökmek istiyorsanız — bir OCR / metin tanıma modeli kullanın - Bölge başına açıklamalar yerine görselin tamamı için tek bir açıklama istiyorsanız — bir görsel açıklama (image captioning) modeli kullanın - Kutular yerine piksel hassasiyetinde maskeler istiyorsanız — bir görsel segmentasyon modeli kullanın
## İpuçları - Net ve makul ölçüde yüksek çözünürlüklü bir fotoğraf verin; piksel arttıkça hem daha fazla bölge çıkar hem de bölgeler daha iyi tarif edilir. - Dönen görsel, bölge kutularının ve açıklama etiketlerinin zaten çizili olduğu standart bir PNG’dir; doğrudan gösterebilir ya da orijinaliyle karşılaştırabilirsiniz. - Bölge açıklamaları, bölgeye göre tarif edici ifadelerle kısa sınıf adlarını karıştırır — aynı sonuçta ikisini birden görmeyi bekleyin. - Ayarlanacak eşik ya da prompt yoktur — aynı görsel üzerindeki her çalıştırma deterministiktir.
## Sınırlamalar - Açıklamalar kısa ve yaklaşıktır; ince nitelikler (tam renk, adet, marka) yanlış olabilir ya da atlanabilir. - Çok küçük, bulanık ya da üst üste binen bölgeler birleştirilebilir, atlanabilir ya da kabaca tarif edilebilir. - Kapsamı model belirler, eksiksiz değildir — bazı bölgeler açıklamasız kalabilir.
ModelRunner JavaScript client ile çalıştırmak için: ```js import { modelrunner } from "@modelrunner/client";
const result = await modelrunner.subscribe("microsoft/florence-2-large/dense-region-caption", { input: { image_url: "https://media.modelrunner.ai/example-storefront-scene.png", }, }); ```