
Ana içeriğe geç
boogu avatarı

Boogu-Image API

boogu/boogu-image

CFG guidance schedule üzerinde ince ayarlı kontrolle, metin prompt’undan yüksek kaliteli görseller üretin.

görsel megapikseli başına 0.04

Model girdisi

Input

The text prompt describing the image to generate.

The size of the generated image. Use a preset string (e.g. 'landscape_16_9') or a custom {width, height} object.

The negative prompt to use. Use it to address details that you don't want in the image.

Additional Settings

Customize your input with more control.

Min: 20 - Max: 50

The number of inference steps to perform. More steps can improve detail at the cost of speed.

Min: 1 - Max: 8

The CFG (Classifier Free Guidance) scale. Higher values increase adherence to the prompt.

The format of the generated image.

The same seed and the same prompt given to the same version of the model will output the same image every time.

Min: 1 - Max: 4

The number of images to generate. Each generated image is billed.

You need to be logged in to run this model and view results.
Log in

Model çıktısı

Output

Generated image output
Generated in 14.454 seconds
Logs (1 lines)

Örnek istekler

Örnekler

Example output 1Example output 2

Boogu-Image API

Boogu-Image is a text-to-image AI model by boogu. On ModelRunner it runs through a REST API or via MCP from any AI assistant, at $0.04 per megapixel.

POST https://queue.modelrunner.run/boogu/boogu-image

cURL

# Submit a request to the queue. Input fields go at the top level of the
# body. The optional reserved "metadata" object holds your own flat string
# tags — stored on the request, never sent to the model; filter later with
# GET https://queue.modelrunner.run/requests?metadata=<url-encoded JSON>.
curl -X POST https://queue.modelrunner.run/boogu/boogu-image \
  -H "Authorization: Key $MRUN_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
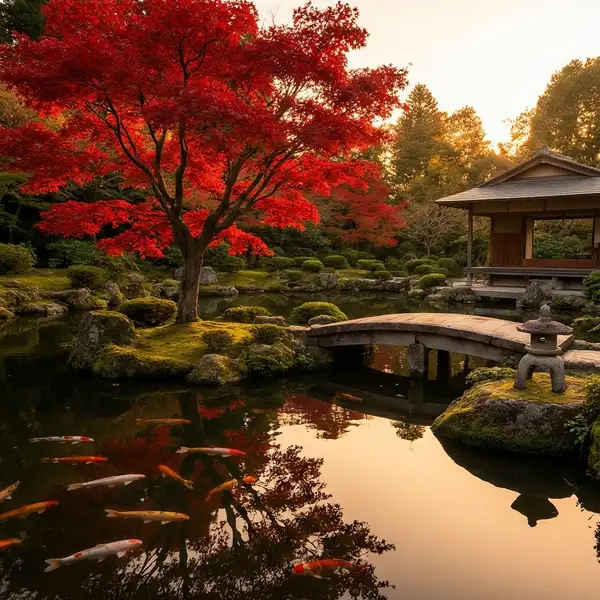
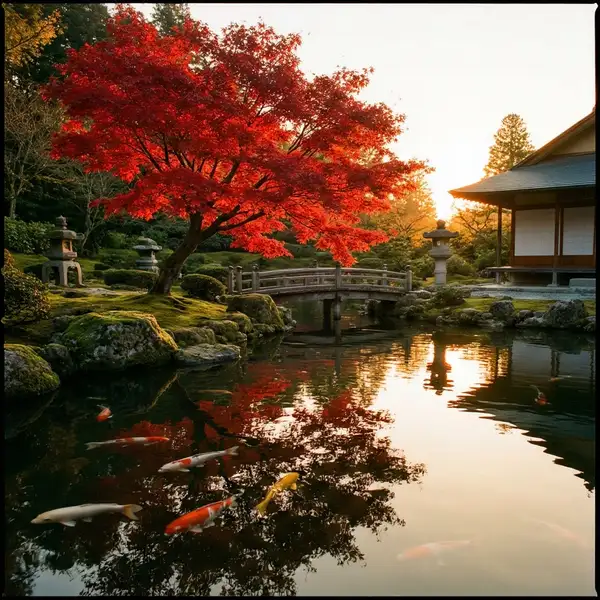
    "prompt": "A serene Japanese garden with a red maple tree reflected in a calm koi pond at golden hour, ultra detailed, cinematic",
    "image_size": "square_hd",
    "num_images": 1,
    "output_format": "jpeg",
    "guidance_scale": 4,
    "negative_prompt": "",
    "num_inference_steps": 30,
    "metadata": {
      "project": "my-project"
    }
  }'
# → { "request_id": "...", "status_url": "...", "response_url": "..." }

# Poll status_url until "COMPLETED", then fetch the result
curl "https://queue.modelrunner.run/boogu/boogu-image/requests/$REQUEST_ID/status" \
  -H "Authorization: Key $MRUN_API_KEY"
curl "https://queue.modelrunner.run/boogu/boogu-image/requests/$REQUEST_ID" \
  -H "Authorization: Key $MRUN_API_KEY"

JavaScript

import { modelrunner } from "@modelrunner/client";

const result = await modelrunner.subscribe("boogu/boogu-image", {
  input: {
    "prompt": "A serene Japanese garden with a red maple tree reflected in a calm koi pond at golden hour, ultra detailed, cinematic",
    "image_size": "square_hd",
    "num_images": 1,
    "output_format": "jpeg",
    "guidance_scale": 4,
    "negative_prompt": "",
    "num_inference_steps": 30
  },
});
console.log(result);

Python

import os
import requests

headers = {"Authorization": f"Key {os.environ['MRUN_API_KEY']}"}

submitted = requests.post(
    "https://queue.modelrunner.run/boogu/boogu-image",
    headers=headers,
    json={
      "prompt": "A serene Japanese garden with a red maple tree reflected in a calm koi pond at golden hour, ultra detailed, cinematic",
      "image_size": "square_hd",
      "num_images": 1,
      "output_format": "jpeg",
      "guidance_scale": 4,
      "negative_prompt": "",
      "num_inference_steps": 30
    },
).json()

# Poll submitted["status_url"] until "COMPLETED", then:
result = requests.get(submitted["response_url"], headers=headers).json()

Input parameters

Input parameters of Boogu-Image
NameTypeRequiredDescription
promptstringyesThe text prompt describing the image to generate.
image_sizeenumnoThe size of the generated image. Use a preset string (e.g. 'landscape_16_9') or a custom {width, height} object. One of: square_hd, square, portrait_4_3, portrait_16_9, landscape_4_3, landscape_16_9. Default: "square_hd".
negative_promptstringnoThe negative prompt to use. Use it to address details that you don't want in the image. Default: "".
num_inference_stepsintegernoThe number of inference steps to perform. More steps can improve detail at the cost of speed. Default: 30.
guidance_scalenumbernoThe CFG (Classifier Free Guidance) scale. Higher values increase adherence to the prompt. Default: 4.
output_formatenumnoThe format of the generated image. One of: jpeg, png. Default: "jpeg".
seedintegernoThe same seed and the same prompt given to the same version of the model will output the same image every time.
num_imagesintegernoThe number of images to generate. Each generated image is billed. Default: 1.

Machine-readable: OpenAPI schema · llms.txt

Use Boogu-Image from Claude & Cursor (MCP)

Point Claude Code, Claude Desktop, Cursor, or any MCP client at the ModelRunner MCP server and Boogu-Image becomes a tool your assistant can call directly — it authorizes via OAuth (no API key in config) and runs this model with the run_model tool using the endpoint boogu/boogu-image.

MCP client config (Claude Desktop, Cursor)

{
  "mcpServers": {
    "modelrunner": {
      "command": "npx",
      "args": ["-y", "mcp-remote", "https://mcp.modelrunner.run/mcp"]
    }
  }
}

Claude Code

claude mcp add --transport http modelrunner https://mcp.modelrunner.run/mcp

Then ask your assistant, for example: “Run boogu/boogu-image on ModelRunner to generate image”. MCP setup guide.

Model Detayları

Model Detayları

Boogu-Image, metin prompt’unu yüksek kaliteli bir görsele dönüştürür. Sahneyi tarif eden bir prompt yazıp bir en-boy oranı seçersiniz; model güçlü prompt uyumuyla ayrıntılı ve tutarlı görseller render eder. Öne çıkan kontrolü CFG guidance schedule: denoising süreci boyunca prompt’un ne kadar güçlü uygulanacağını şekillendirebilirsiniz; bu da yazdıklarınıza sadakat ile doğal görünen detay arasında denge kurmayı kolaylaştırır. İstek başına en fazla dört görsel üretebilir ve kareden geniş yataya kadar yaygın en-boy oranlarını destekler.

## En uygun olduğu işler - Genel text-to-image üretimi: yazılı bir açıklamadan sahneler, karakterler, ürünler, konsept çizimler ve illüstrasyonlar - Aynı anda birkaç varyasyon üreterek tek bir fikir üzerinde yinelemek (istek başına en fazla dört) - Kırpmaya gerek kalmadan belirli bir en-boy oranını (kare, dikey ya da yatay) hedeflemek - Prompt uyumu ve detay arasındaki dengeyi guidance scale ve CFG schedule üzerinden ince ayarlamak

## Şu durumlarda başka bir model seçin - Sıfırdan üretmek yerine mevcut bir görseli düzenlemek, inpaint etmek ya da yeniden tarzlamak istiyorsanız — bir görsel düzenleme modeli kullanın - Asıl hedefiniz görselin içine uzun ve harfi harfine doğru yazılmış metin basmaksa — görsel içi metinde uzmanlaşmış bir model kullanın - Video çıktısı gerekiyorsa — bir text-to-video ya da image-to-video modeli kullanın

## İpuçları - Özneyi ve en önemli ayrıntıları prompt’un başına yazın; istenmeyen öğeleri dışarıda bırakmak için `negative_prompt` kullanın - Prompt’a daha sıkı uyum için `guidance_scale` değerini yükseltin; daha doğal ve daha az kısıtlı sonuçlar için düşürün - Kayıpsız çıktı gerektiğinde `output_format` alanını `png` yapın; varsayılan `jpeg` daha küçük ve daha hızlıdır - Bir sonucu yeniden üretmek ya da her seferinde tek bir ayarı değiştirerek denemek için sabit bir `seed` verin

ModelRunner JavaScript client ile çalıştırmak için: ```js import { modelrunner } from "@modelrunner/client";

const result = await modelrunner.subscribe("boogu/boogu-image", { input: { prompt: "A red apple on a white marble table, soft studio lighting", image_size: "square_hd", num_images: 1, }, }); ```