
Ana içeriğe geç
microsoft avatarı

Florence-2 Large OCR with Region API

microsoft/florence-2-large/ocr-with-region

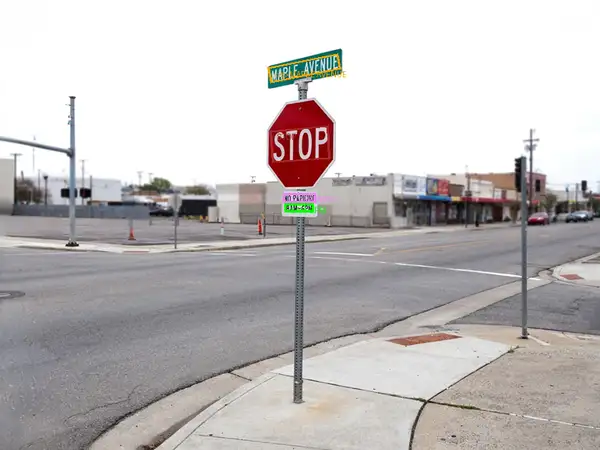
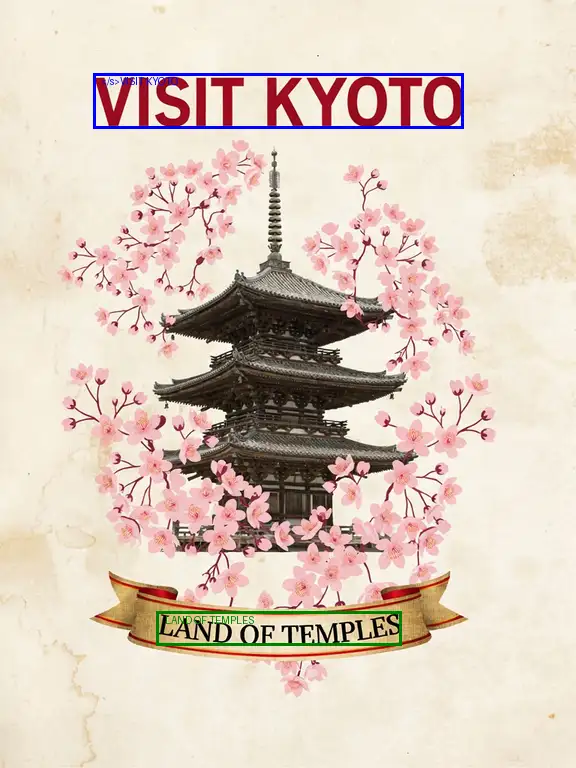
Bir fotoğraftaki metni bulup okuyun ve işaretlenmiş bir görsel alın: tespit edilen her metin bölgesi kutuya alınır ve üzerinde yazanla etiketlenir.

0.01

Model girdisi

Input

URL of the image to read and locate text in.

You need to be logged in to run this model and view results.
Log in

Model çıktısı

Output

Loading
Generated in 1.237 seconds
Logs (1 lines)

Örnek istekler

Örnekler

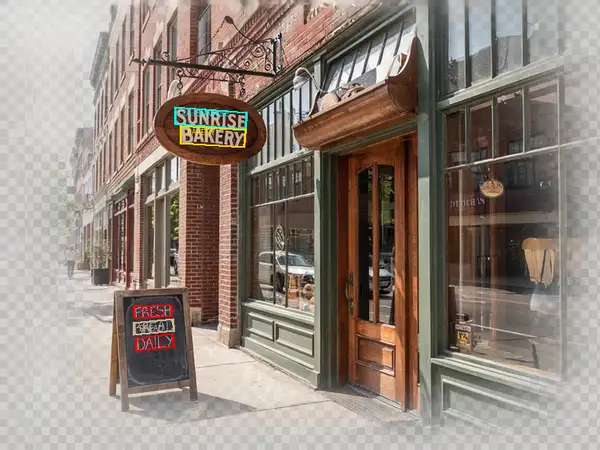
Example output 1Example output 2Example output 3

Florence-2 Large OCR with Region API

Florence-2 Large OCR with Region is a image-to-image AI model by microsoft. On ModelRunner it runs through a REST API or via MCP from any AI assistant, at $0.01 per image.

POST https://queue.modelrunner.run/microsoft/florence-2-large/ocr-with-region

cURL

# Submit a request to the queue. Input fields go at the top level of the
# body. The optional reserved "metadata" object holds your own flat string
# tags — stored on the request, never sent to the model; filter later with
# GET https://queue.modelrunner.run/requests?metadata=<url-encoded JSON>.
curl -X POST https://queue.modelrunner.run/microsoft/florence-2-large/ocr-with-region \
  -H "Authorization: Key $MRUN_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "image_url": "https://media.modelrunner.ai/AYNyr8m1LML8WuGC75n9B.jpeg",
    "metadata": {
      "project": "my-project"
    }
  }'
# → { "request_id": "...", "status_url": "...", "response_url": "..." }

# Poll status_url until "COMPLETED", then fetch the result
curl "https://queue.modelrunner.run/microsoft/florence-2-large/ocr-with-region/requests/$REQUEST_ID/status" \
  -H "Authorization: Key $MRUN_API_KEY"
curl "https://queue.modelrunner.run/microsoft/florence-2-large/ocr-with-region/requests/$REQUEST_ID" \
  -H "Authorization: Key $MRUN_API_KEY"

JavaScript

import { modelrunner } from "@modelrunner/client";

const result = await modelrunner.subscribe("microsoft/florence-2-large/ocr-with-region", {
  input: {
    "image_url": "https://media.modelrunner.ai/AYNyr8m1LML8WuGC75n9B.jpeg"
  },
});
console.log(result);

Python

import os
import requests

headers = {"Authorization": f"Key {os.environ['MRUN_API_KEY']}"}

submitted = requests.post(
    "https://queue.modelrunner.run/microsoft/florence-2-large/ocr-with-region",
    headers=headers,
    json={
      "image_url": "https://media.modelrunner.ai/AYNyr8m1LML8WuGC75n9B.jpeg"
    },
).json()

# Poll submitted["status_url"] until "COMPLETED", then:
result = requests.get(submitted["response_url"], headers=headers).json()

Input parameters

Input parameters of Florence-2 Large OCR with Region
NameTypeRequiredDescription
image_urlstring (uri)yesURL of the image to read and locate text in.

Machine-readable: OpenAPI schema · llms.txt

Use Florence-2 Large OCR with Region from Claude & Cursor (MCP)

Point Claude Code, Claude Desktop, Cursor, or any MCP client at the ModelRunner MCP server and Florence-2 Large OCR with Region becomes a tool your assistant can call directly — it authorizes via OAuth (no API key in config) and runs this model with the run_model tool using the endpoint microsoft/florence-2-large/ocr-with-region.

MCP client config (Claude Desktop, Cursor)

{
  "mcpServers": {
    "modelrunner": {
      "command": "npx",
      "args": ["-y", "mcp-remote", "https://mcp.modelrunner.run/mcp"]
    }
  }
}

Claude Code

claude mcp add --transport http modelrunner https://mcp.modelrunner.run/mcp

Then ask your assistant, for example: “Run microsoft/florence-2-large/ocr-with-region on ModelRunner to generate image”. MCP setup guide.

Model Detayları

Model Detayları

Florence-2 Large OCR with Region, bir fotoğrafta metnin nerede geçtiğini bulur, okur ve tespit ettiği her metin bölgesinin, tanınan metni gösteren etiketli bir kutu olarak çizildiği aynı görseli döndürür. Bir görsel URL’si verin; bulduğu her metin bölgesini — tabelalar, ürün etiketleri, başlıklar, basılı satırlar — işaretleyen bir görsel alırsınız, yanında da bölge başına yapılandırılmış sonuçlar gelir (her kutunun konumu ve okuduğu metin). Ne prompt ne de ince ayar gerekir: bir görsel girer, işaretlenmiş bir görsel çıkar. Microsoft’un Florence-2 vision-language temel modeli üzerine kuruludur; tespit ve tanımayı tek geçişte birleştirir, böylece metnin hem *ne* dediğini hem de karede *nerede* durduğunu görürsünüz.

## En uygun olduğu işler - Tabelalardaki, ürün etiketlerindeki, fişlerdeki ve belge fotoğraflarındaki metni okuyup yerini bulmak - İnceleme ya da kalite kontrol için metnin görselde nerede durduğunu etiketli kutularla göstermek - Ambalajlarda, reklamlarda ya da UI ekran görüntülerinde metnin yerleşimini ve kapsamını kontrol etmek - Yalnızca düz bir string değil, hem okunan metnin hem de konumunun gerektiği, konuma dayalı OCR

## Şu durumlarda başka bir model seçin - Kutu ya da koordinat olmadan yalnızca ham metni istiyorsanız — metin döndüren sade bir OCR / metin tanıma modeli kullanın - Metin yerine metin dışı nesneleri (insanlar, araçlar, eşyalar) tespit etmek istiyorsanız — bir nesne tespiti modeli kullanın - Metin bölgeleri yerine sahneyi anlatan yazılı bir açıklama istiyorsanız — bir görsel açıklama (image captioning) modeli kullanın

## İpuçları - Net ve makul ölçüde yüksek çözünürlüklü bir fotoğraf verin; küçük ya da düşük kontrastlı metin, piksel arttıkça daha kolay okunur. - Dönen görsel, metin bölgesi kutularının ve etiketlerin zaten çizili olduğu standart bir PNG’dir; doğrudan gösterebilir ya da orijinaliyle karşılaştırabilirsiniz. - Ayarlanacak eşik ya da prompt yoktur — aynı görsel üzerindeki her çalıştırma deterministiktir. - En iyi sonucu basılı ya da tabela tarzı metinde verir; yoğun paragraflar ve bitişik el yazısı daha zordur.

## Sınırlamalar - Basılı ve iri puntolu metni iyi okur; küçük, bulanık, stilize ya da el yazısıyla yazılmış metin atlanabilir veya yanlış okunabilir. - Üst üste binen ya da sıkışık metin bölgeleri birleştirilebilir ya da bölünebilir. - Çok döndürülmüş ya da belirgin biçimde eğik metnin yeri bulunabilir ama daha az güvenilir okunur.

ModelRunner JavaScript client ile çalıştırmak için: ```js import { modelrunner } from "@modelrunner/client";

const result = await modelrunner.subscribe("microsoft/florence-2-large/ocr-with-region", { input: { image_url: "https://media.modelrunner.ai/example-storefront-sign.png", }, }); ```