
Ana içeriğe geç
bytedance avatarı

Seedream V4.5 Text to Image API

bytedance/seedream-v4.5/text-to-image

ByteDance tarafından geliştirilen yeni nesil bir text-to-image modeli: yüksek sadakatli üretim, isabetli metin basma ve çok ayrıntılı görsel kompozisyonlar için karmaşık stil denetimi.

0.04

Model girdisi

Input

The text prompt used to generate the image

The size of the generated image. Use a preset string (e.g. '4_3_1k') or a custom {width, height} object.

Safety checker can only be disabled on API call

Min: 1 - Max: 4

The number of images to generate. Each generated image is billed.

Random seed to control the stochasticity of image generation.

You need to be logged in to run this model and view results.
Log in

Model çıktısı

Output

Generated image output
Generated in 138.547 seconds
Logs (1 lines)

Örnek istekler

Örnekler

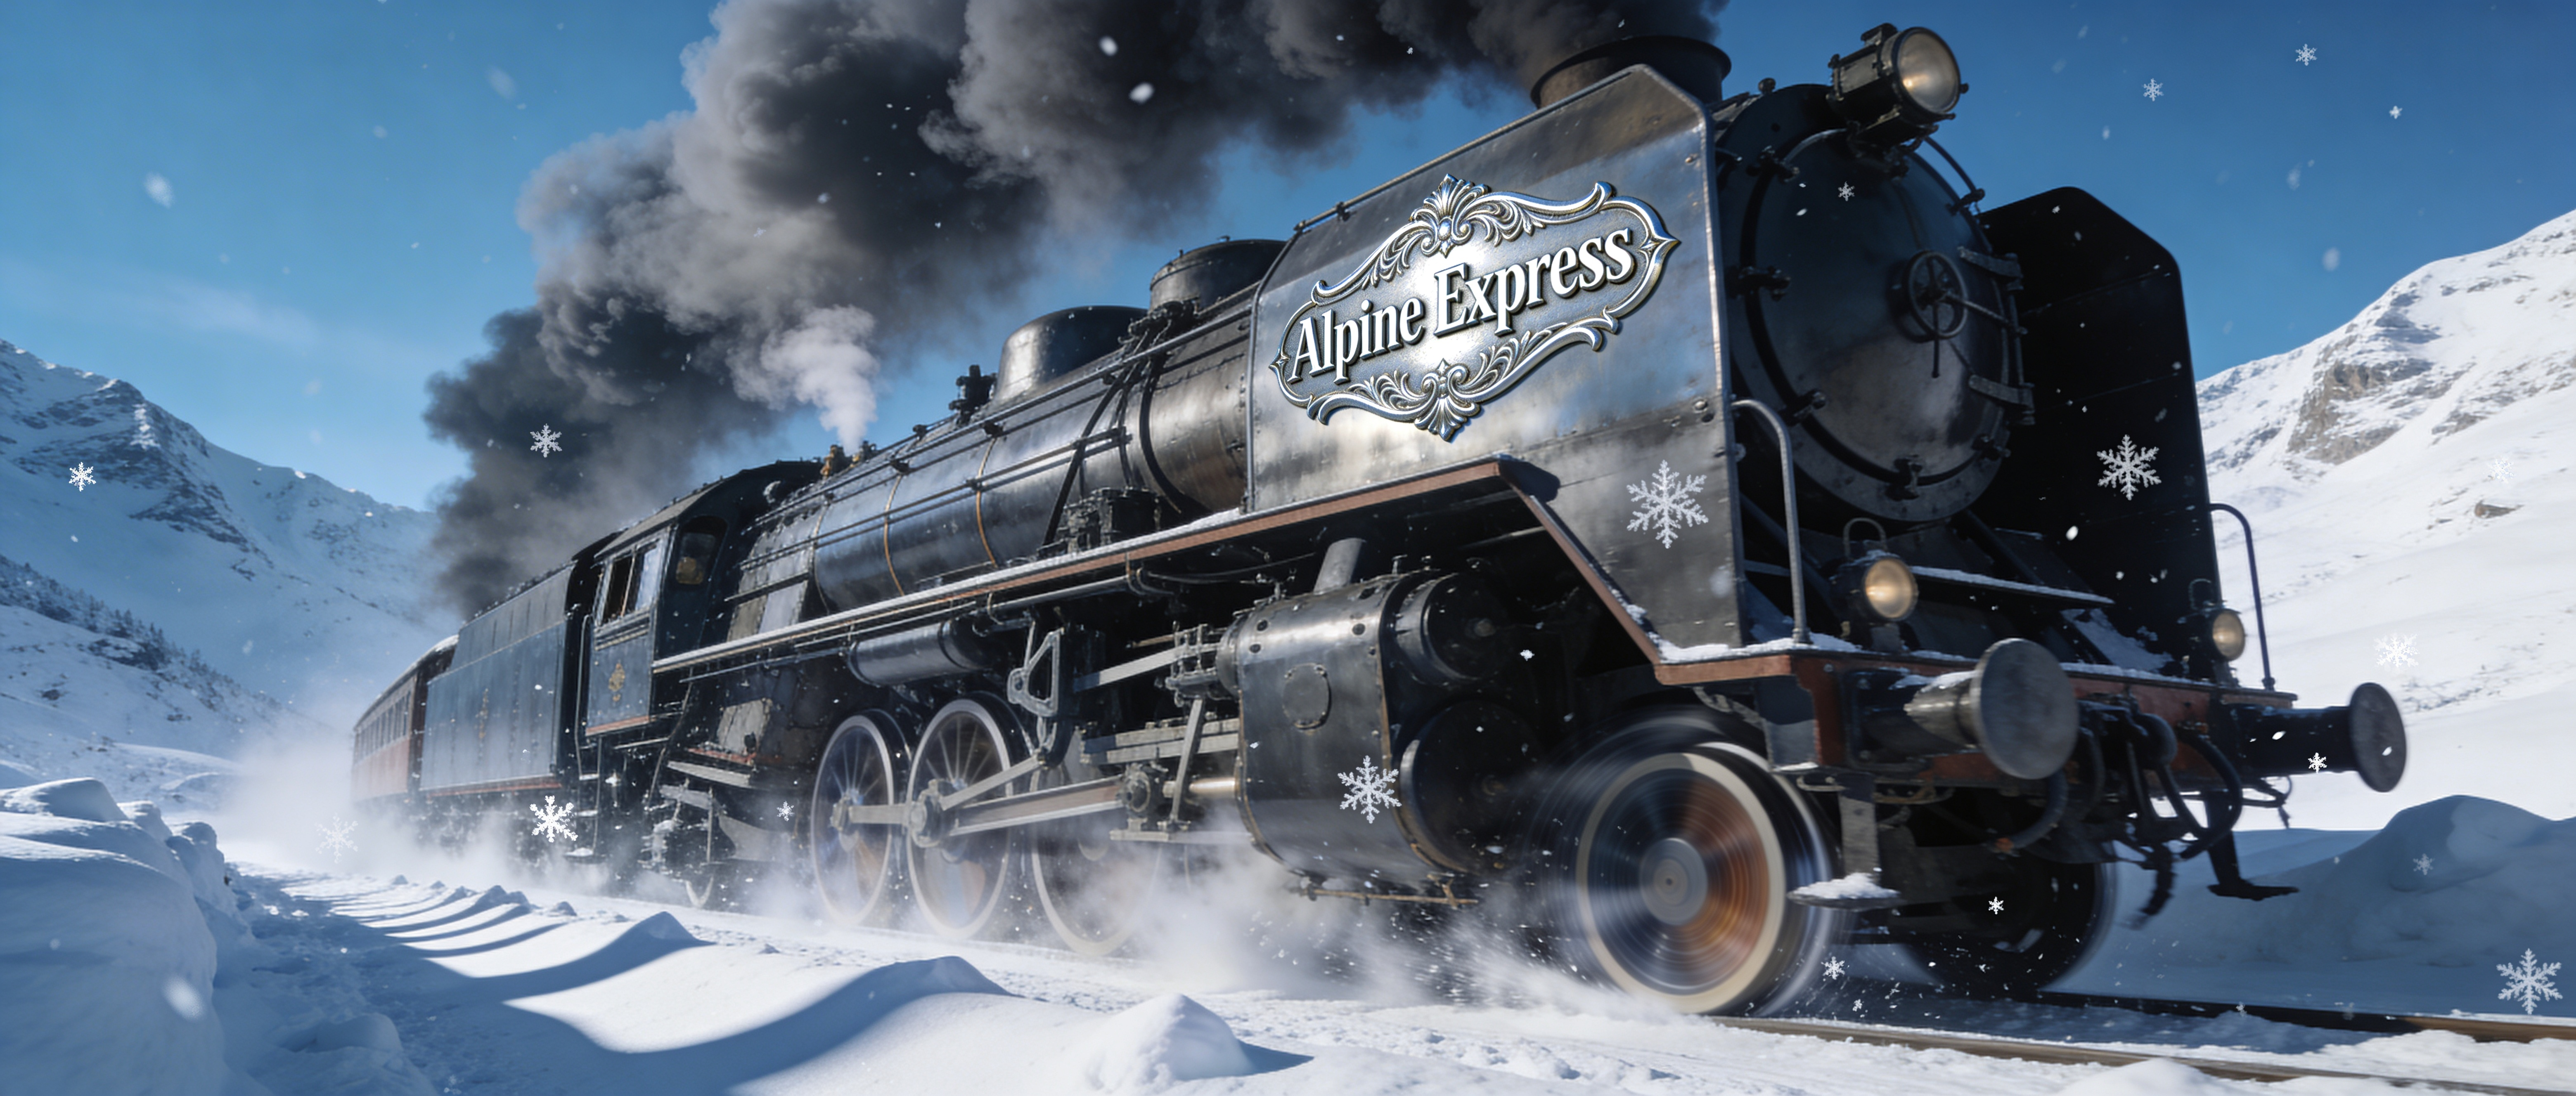
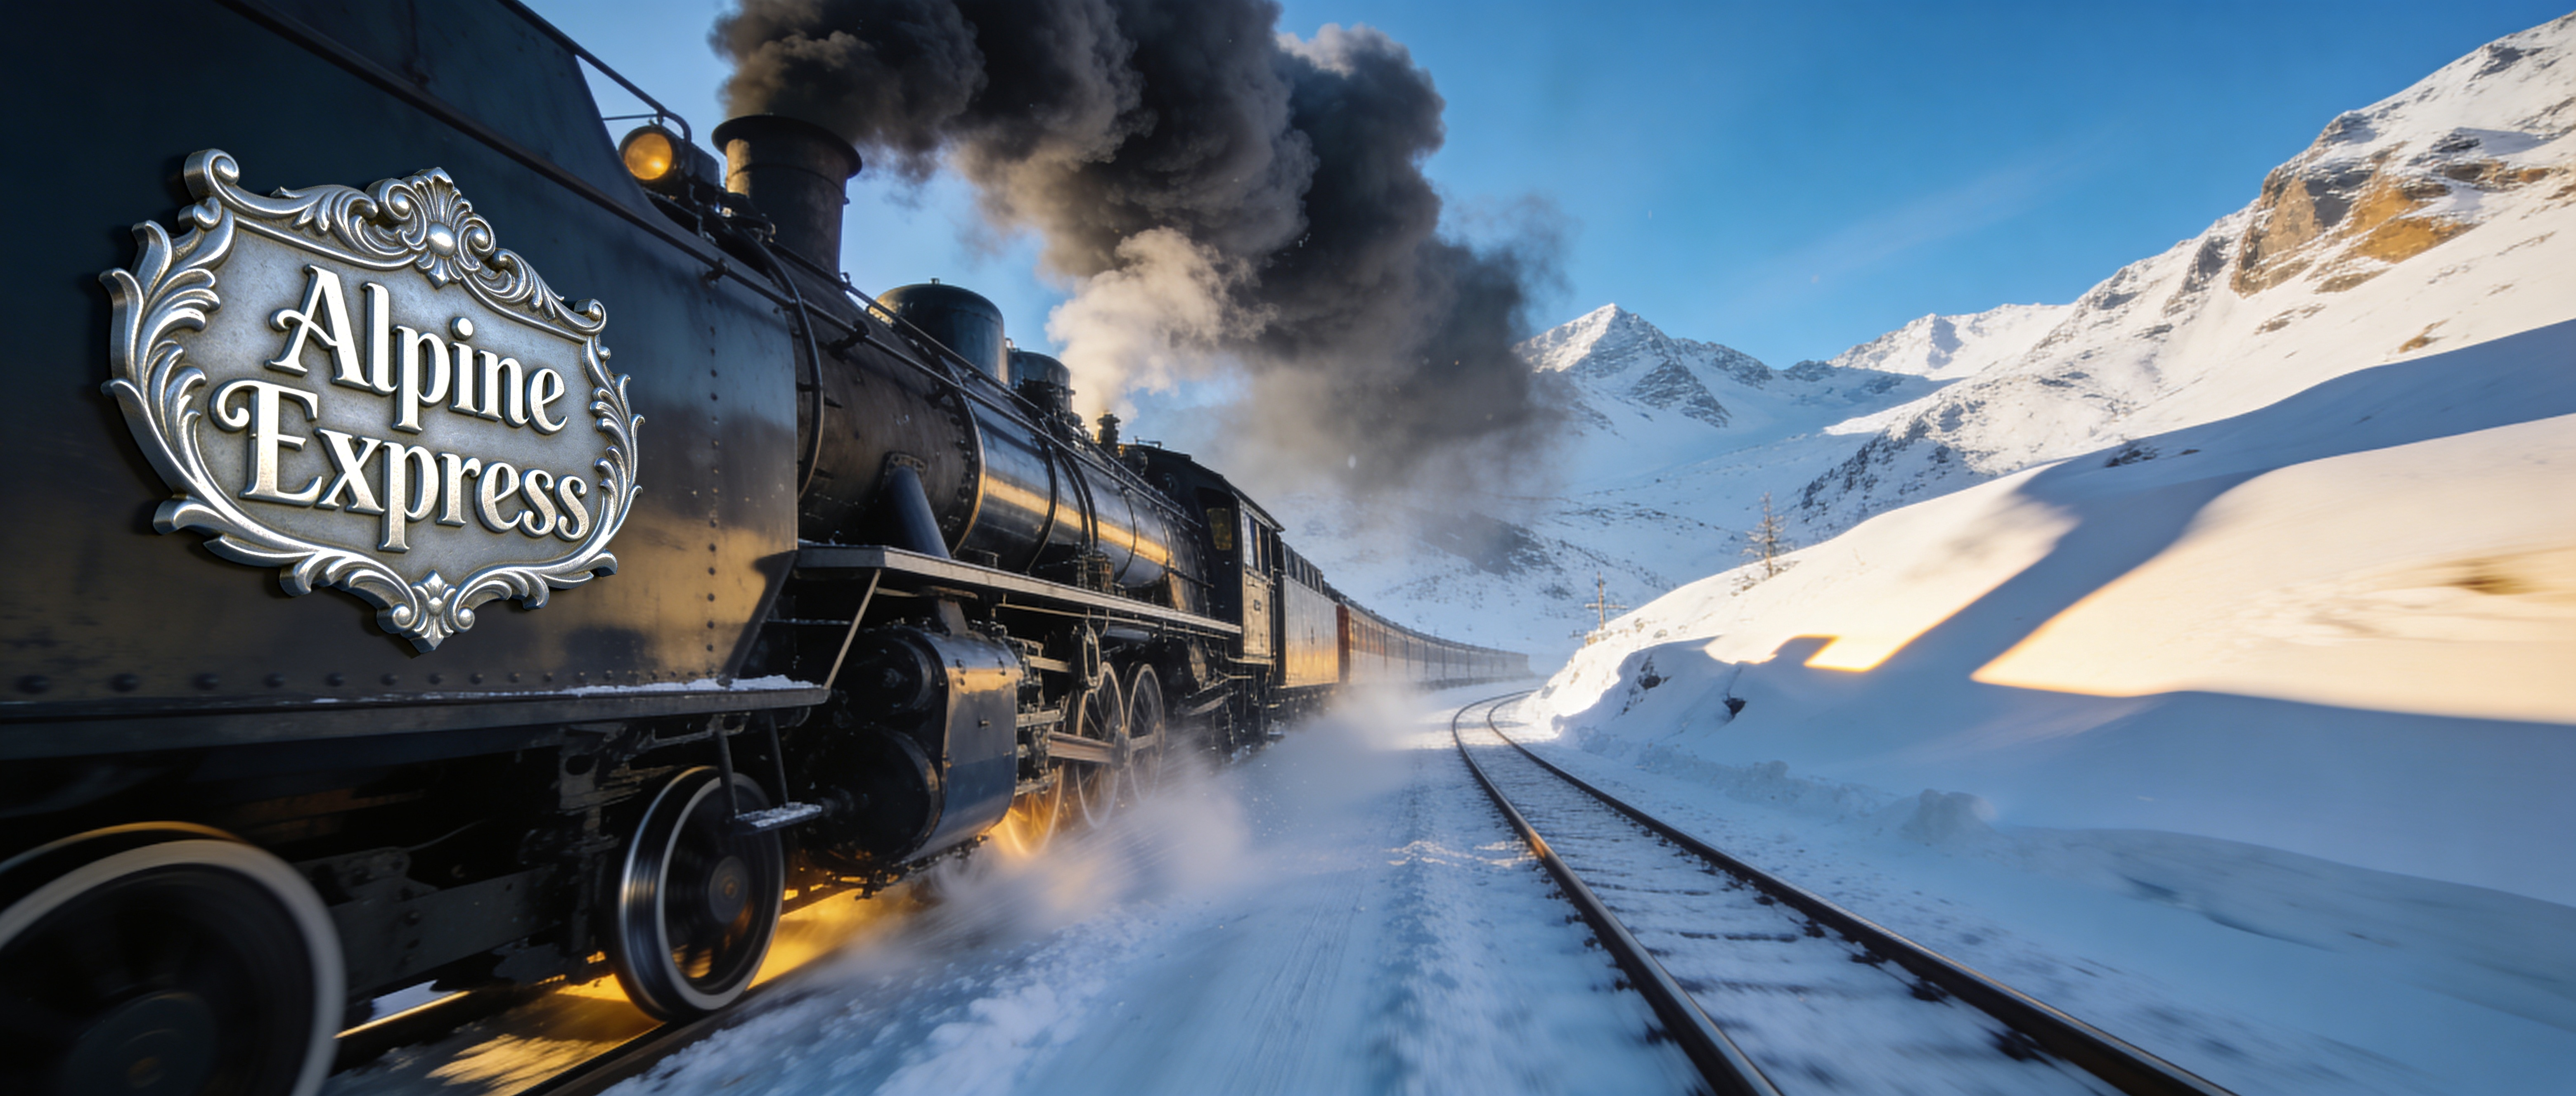
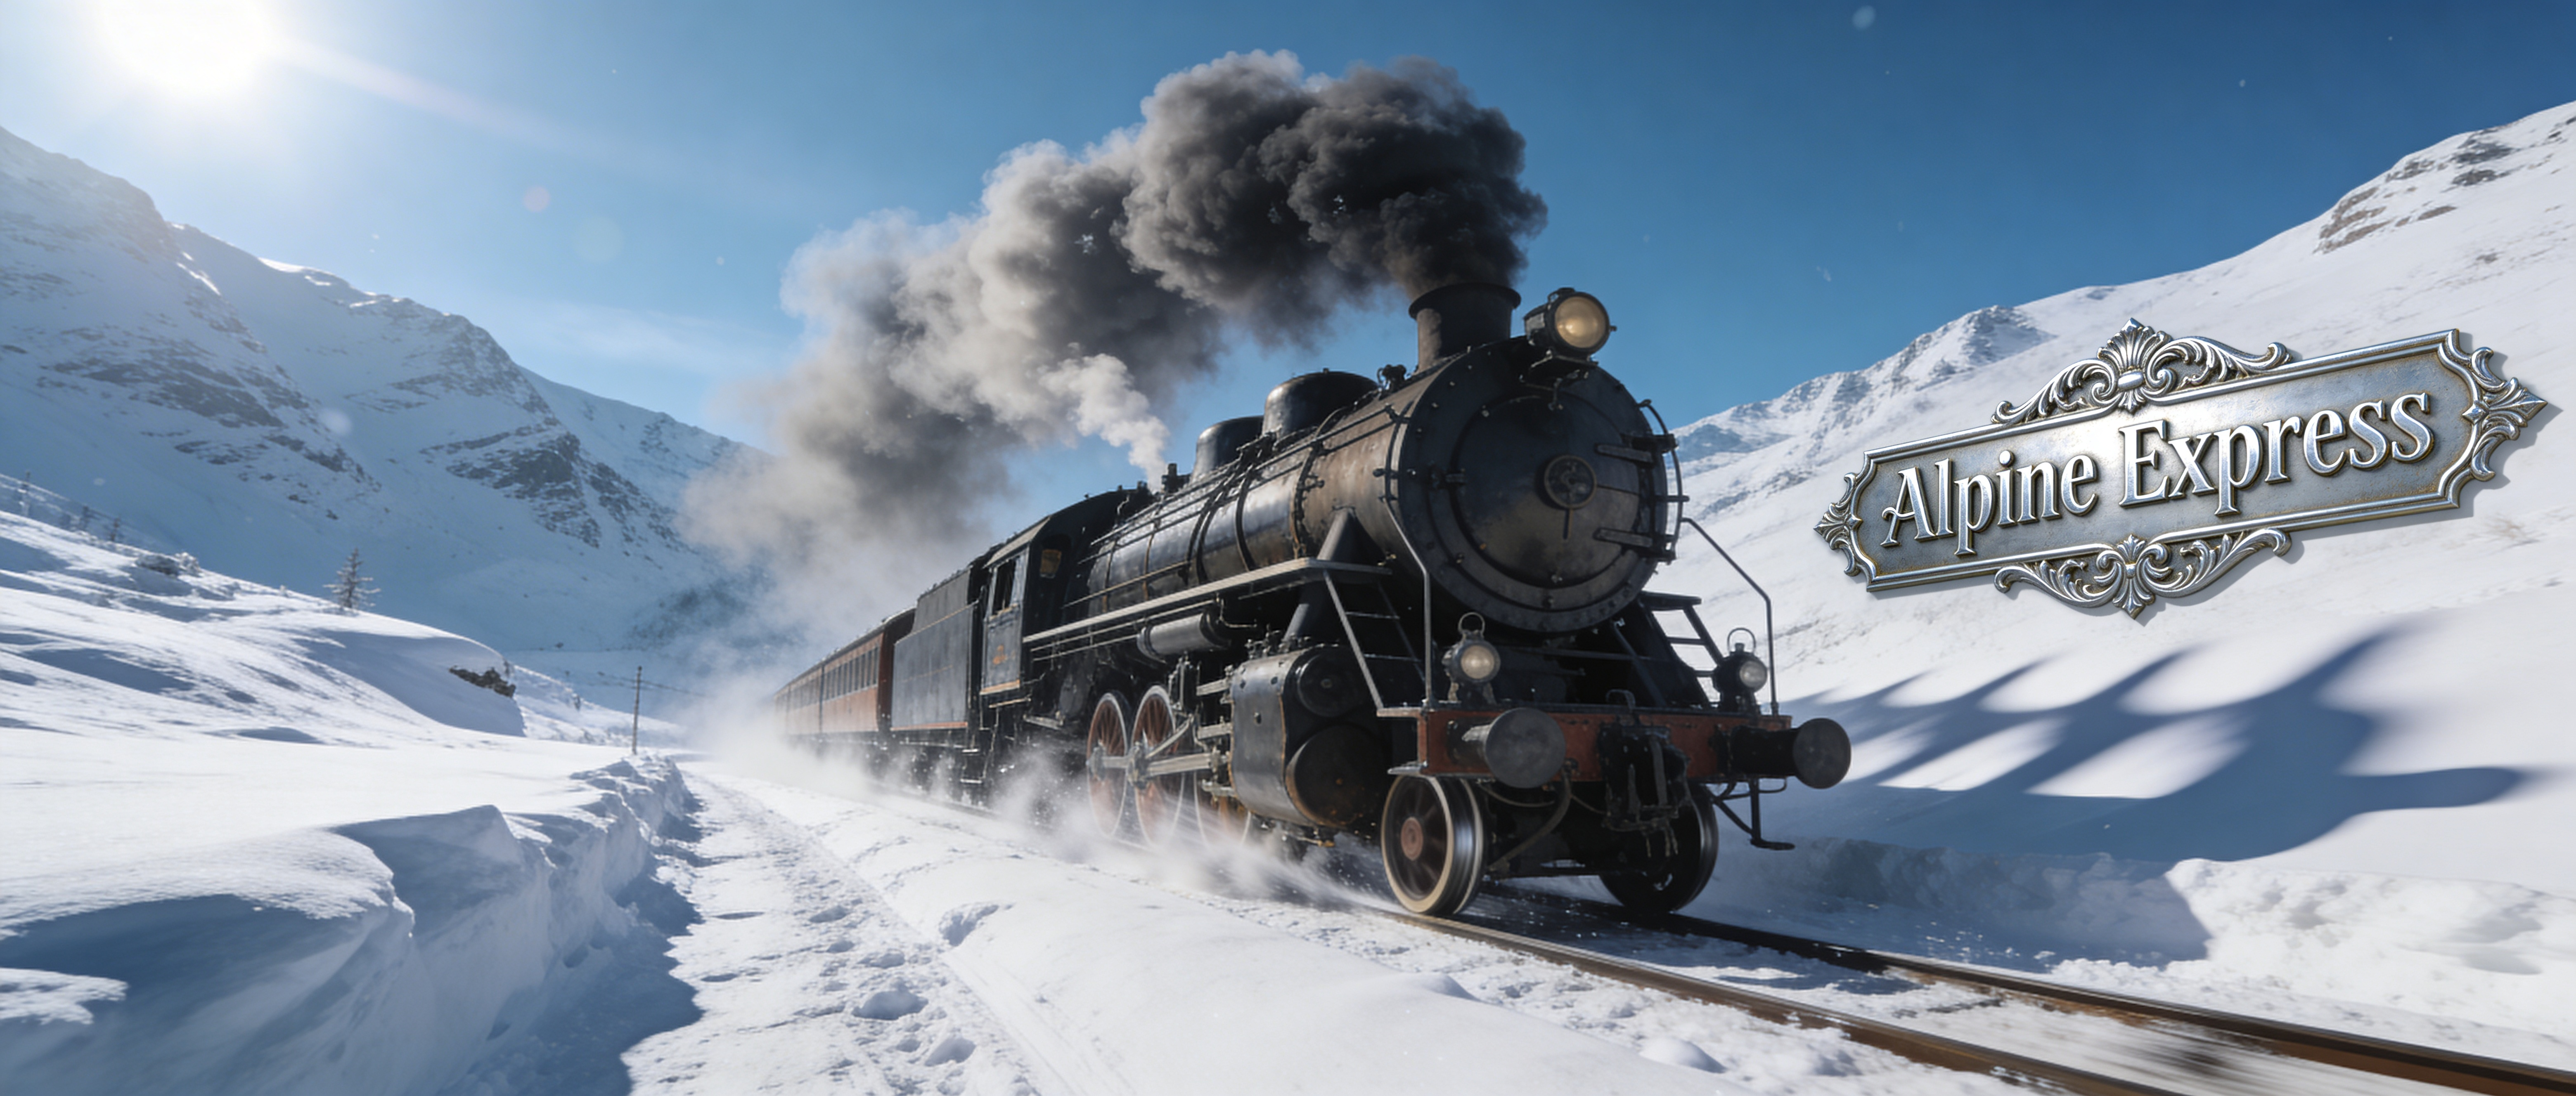
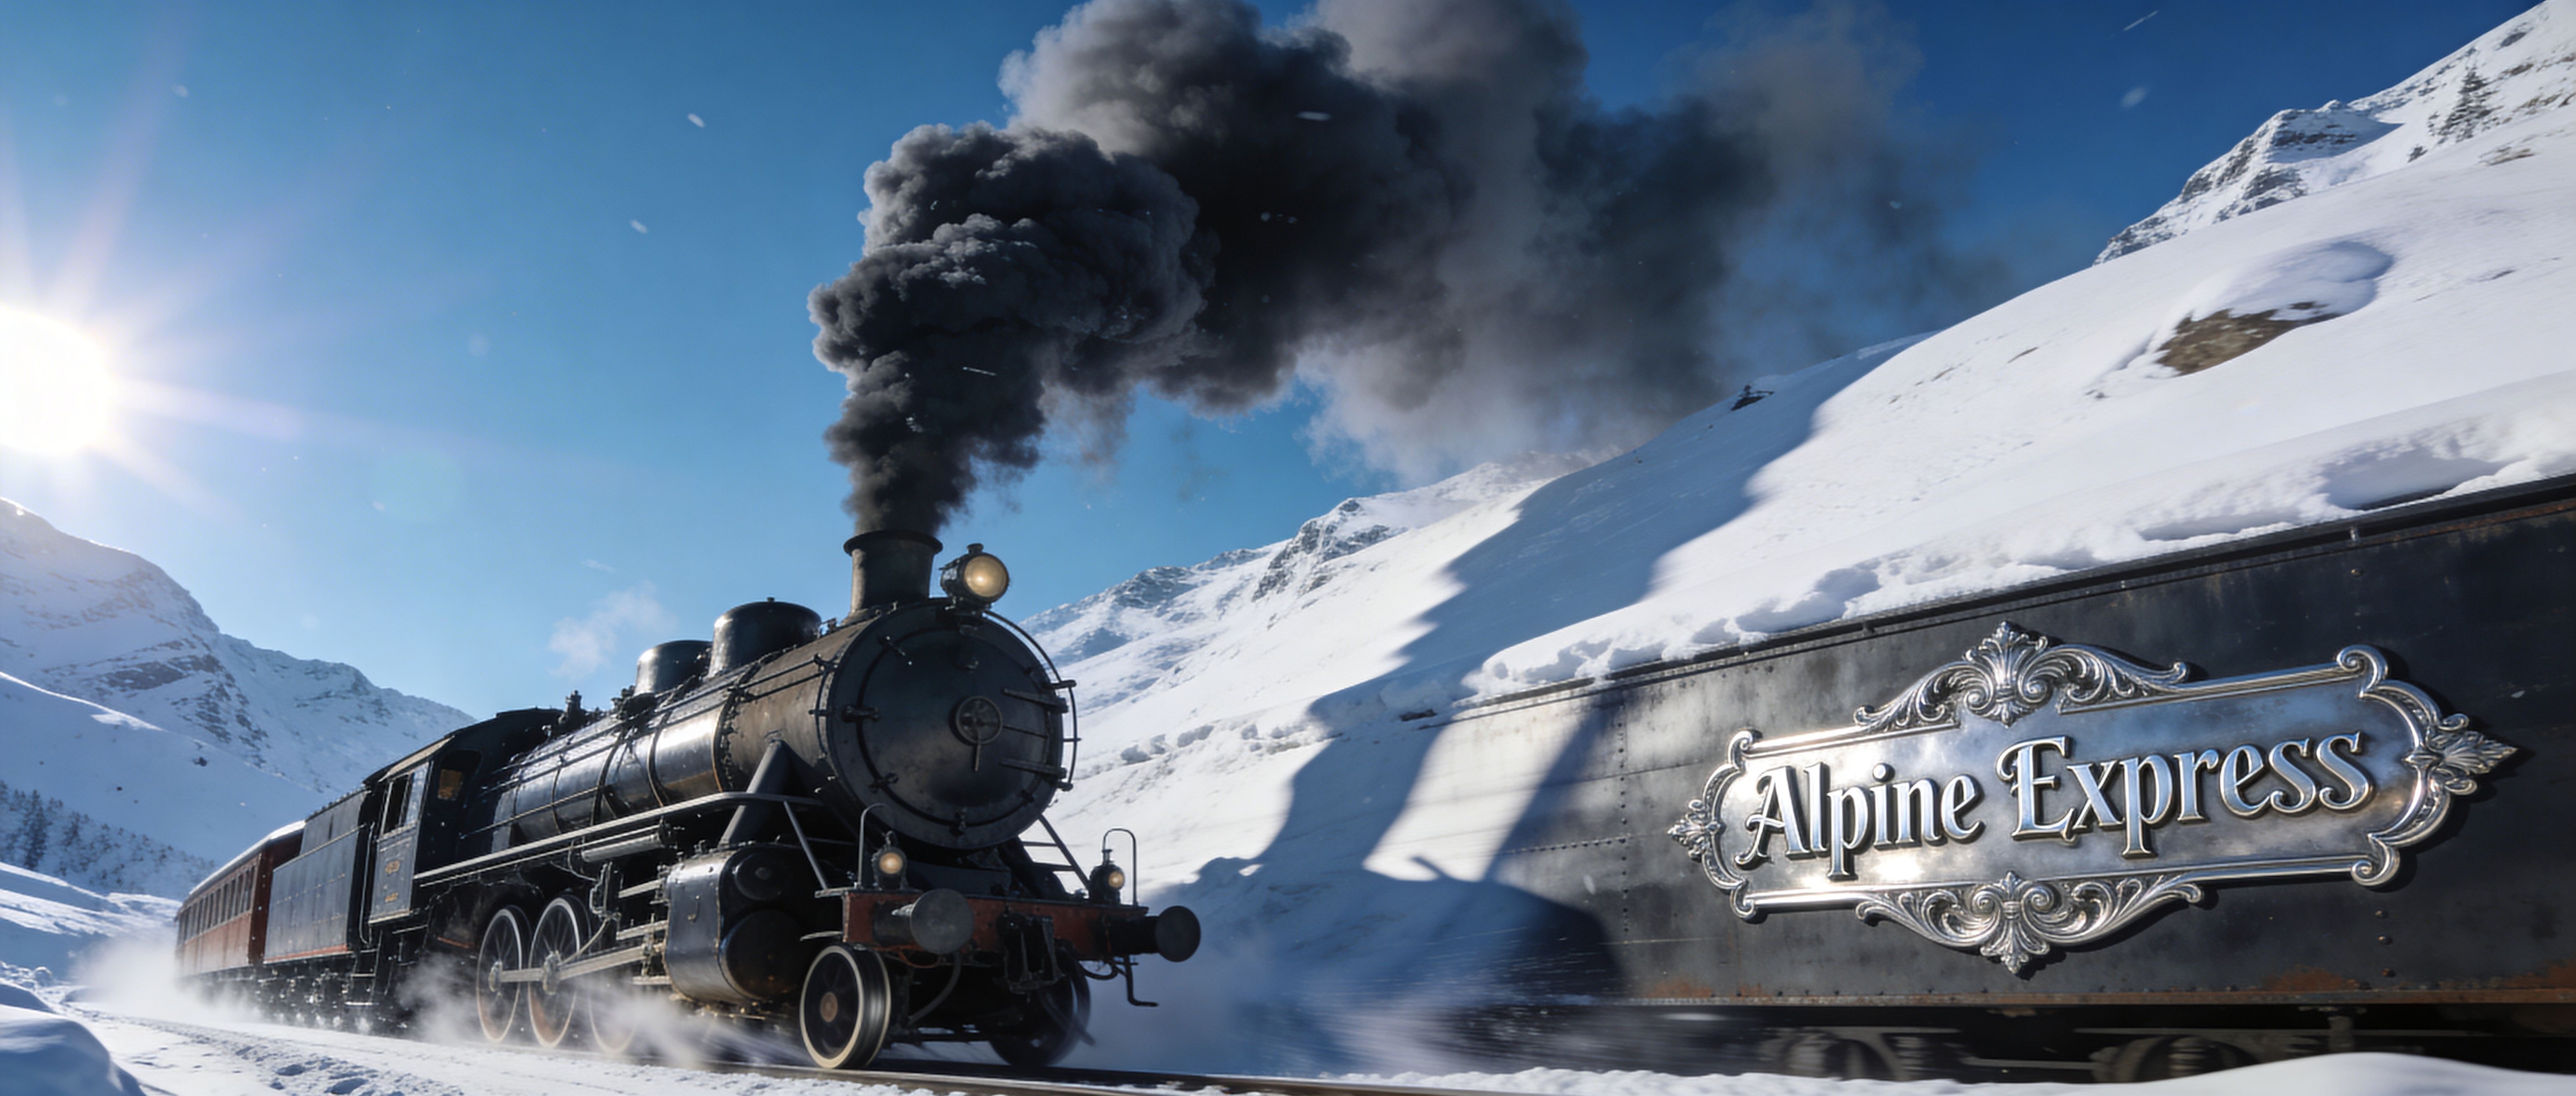
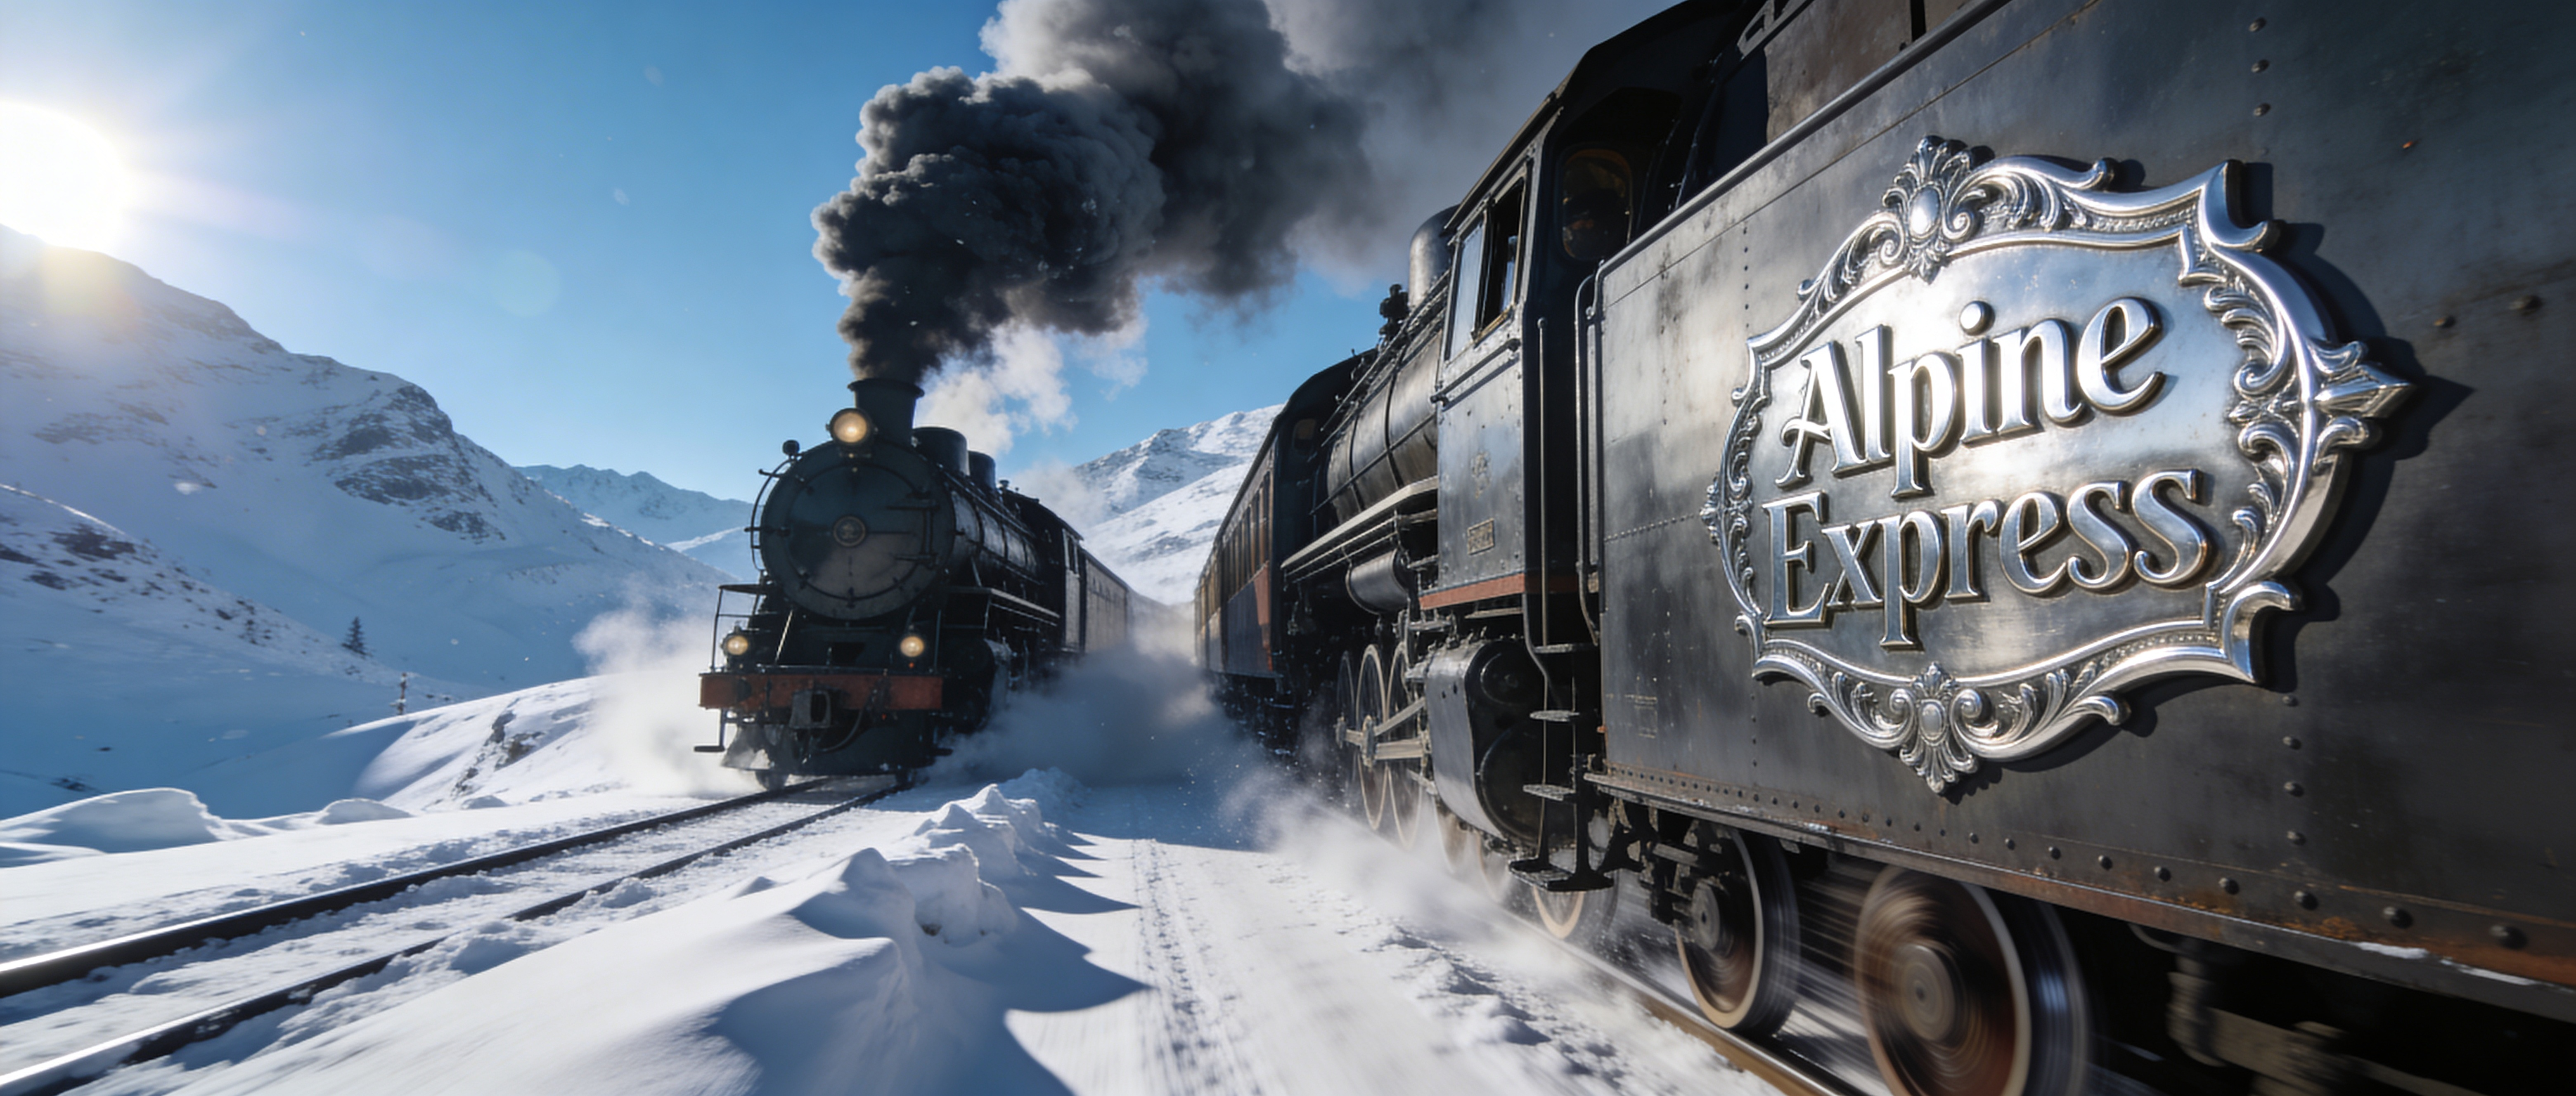
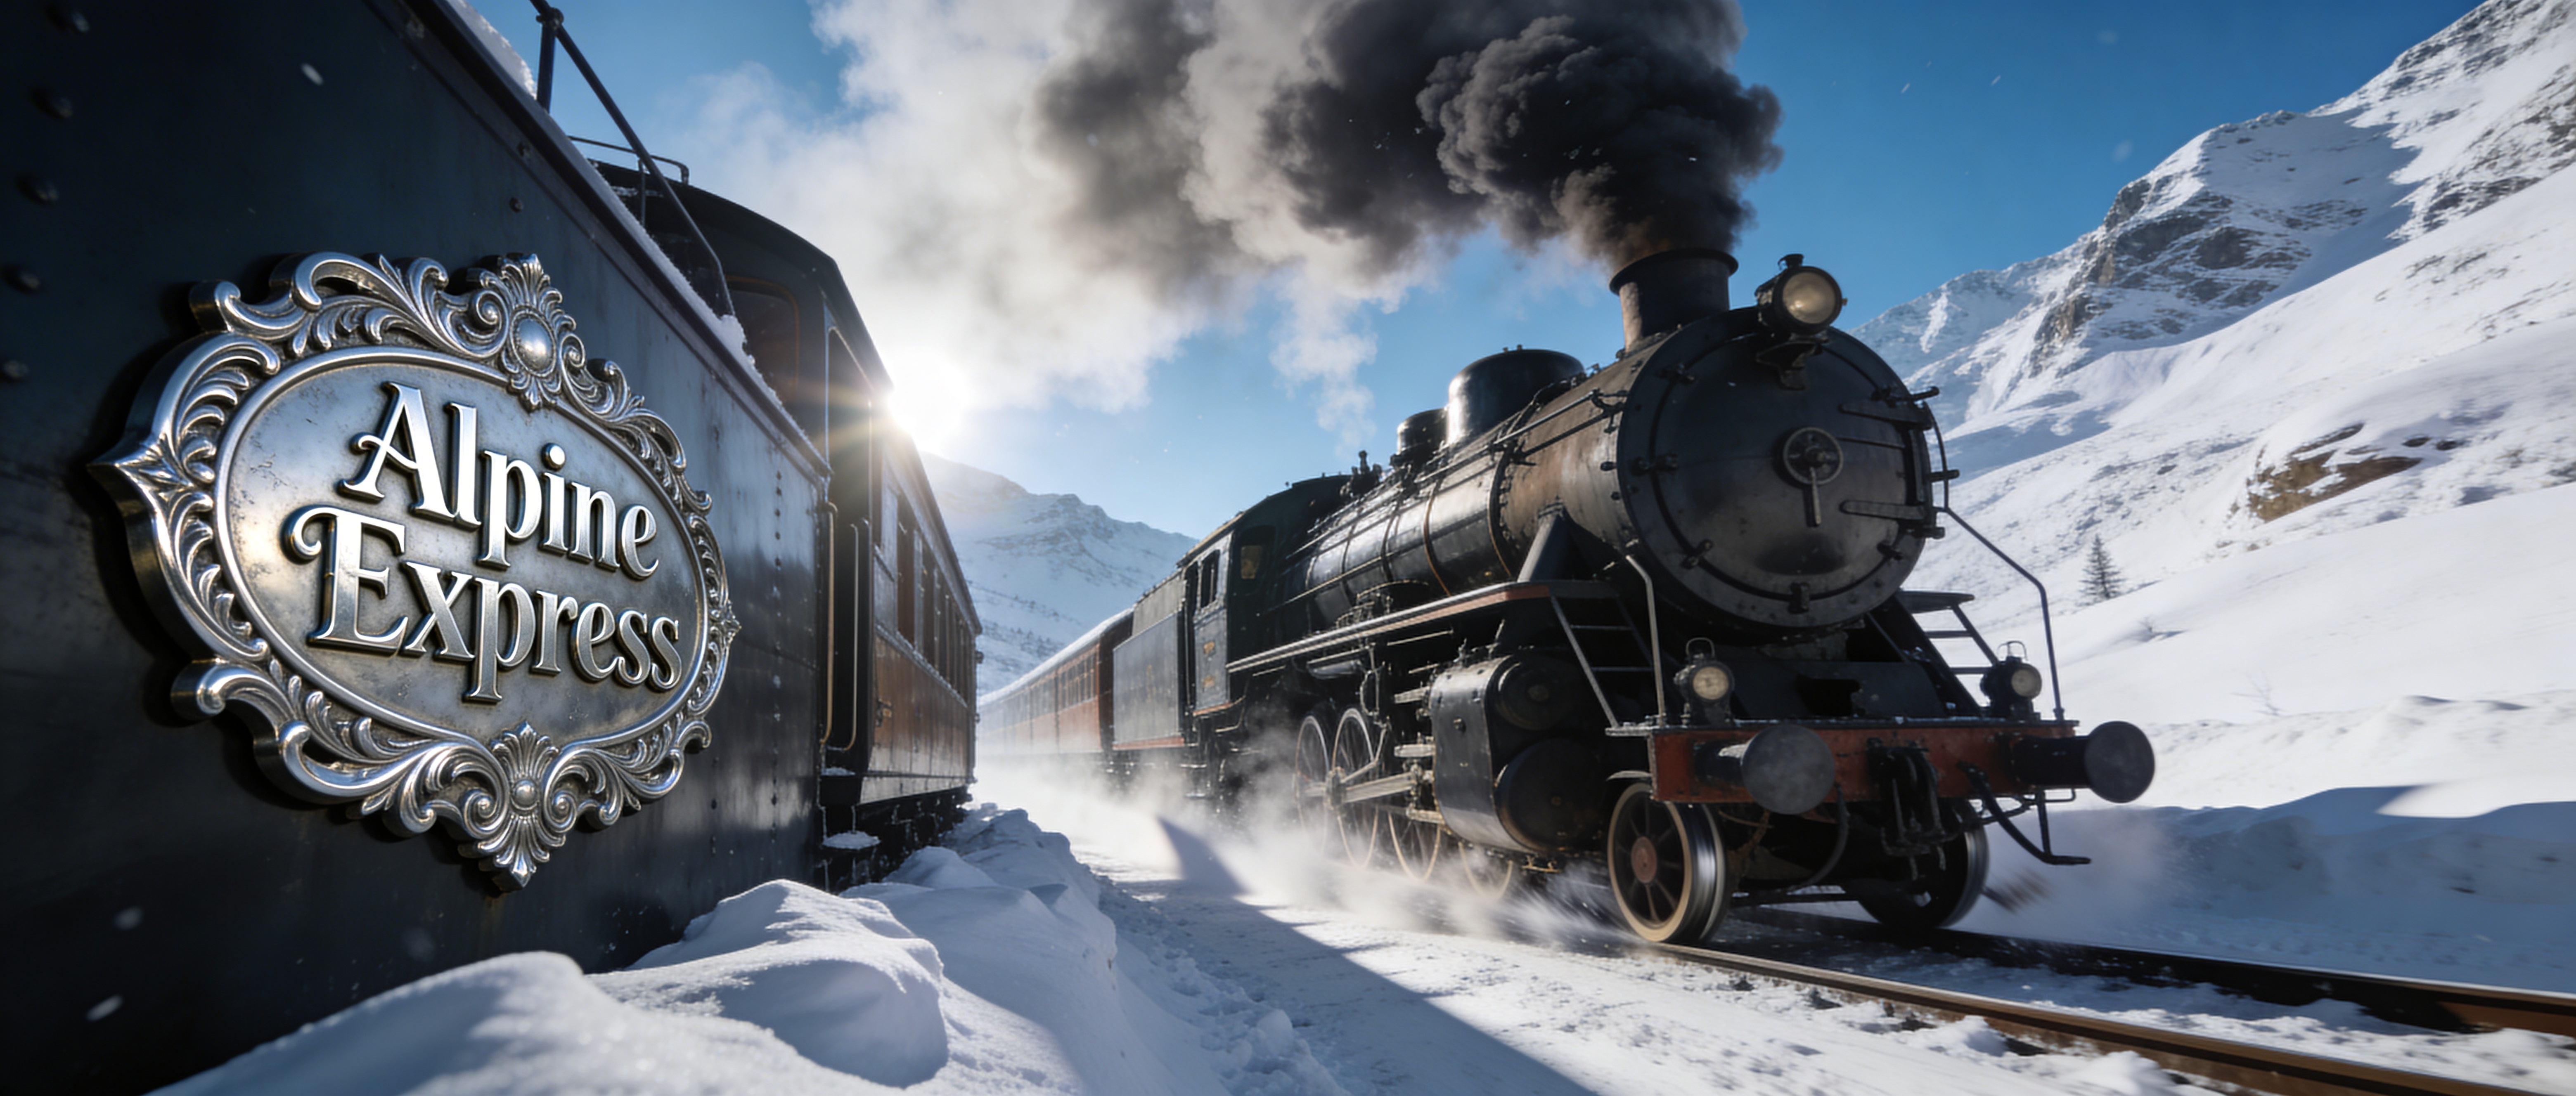
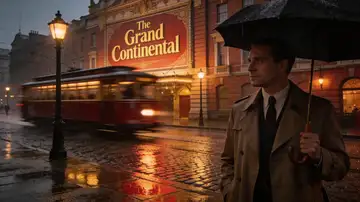
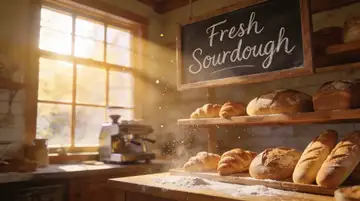
Example output 1Example output 2Example output 3

Seedream V4.5 Text to Image API

Seedream V4.5 Text to Image is a text-to-image AI model by bytedance. On ModelRunner it runs through a REST API or via MCP from any AI assistant, at $0.04 per image.

POST https://queue.modelrunner.run/bytedance/seedream-v4.5/text-to-image

cURL

# Submit a request to the queue. Input fields go at the top level of the
# body. The optional reserved "metadata" object holds your own flat string
# tags — stored on the request, never sent to the model; filter later with
# GET https://queue.modelrunner.run/requests?metadata=<url-encoded JSON>.
curl -X POST https://queue.modelrunner.run/bytedance/seedream-v4.5/text-to-image \
  -H "Authorization: Key $MRUN_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "seed": 841029,
    "prompt": "A low-angle, wide shot of an old-fashioned steam train charging through a heavily snow-covered mountain pass. The mas…",
    "image_size": "auto_4K",
    "max_images": 3,
    "num_images": 2,
    "enable_safety_checker": true,
    "metadata": {
      "project": "my-project"
    }
  }'
# → { "request_id": "...", "status_url": "...", "response_url": "..." }

# Poll status_url until "COMPLETED", then fetch the result
curl "https://queue.modelrunner.run/bytedance/seedream-v4.5/text-to-image/requests/$REQUEST_ID/status" \
  -H "Authorization: Key $MRUN_API_KEY"
curl "https://queue.modelrunner.run/bytedance/seedream-v4.5/text-to-image/requests/$REQUEST_ID" \
  -H "Authorization: Key $MRUN_API_KEY"

JavaScript

import { modelrunner } from "@modelrunner/client";

const result = await modelrunner.subscribe("bytedance/seedream-v4.5/text-to-image", {
  input: {
    "seed": 841029,
    "prompt": "A low-angle, wide shot of an old-fashioned steam train charging through a heavily snow-covered mountain pass. The mas…",
    "image_size": "auto_4K",
    "max_images": 3,
    "num_images": 2,
    "enable_safety_checker": true
  },
});
console.log(result);

Python

import os
import requests

headers = {"Authorization": f"Key {os.environ['MRUN_API_KEY']}"}

submitted = requests.post(
    "https://queue.modelrunner.run/bytedance/seedream-v4.5/text-to-image",
    headers=headers,
    json={
      "seed": 841029,
      "prompt": "A low-angle, wide shot of an old-fashioned steam train charging through a heavily snow-covered mountain pass. The mas…",
      "image_size": "auto_4K",
      "max_images": 3,
      "num_images": 2,
      "enable_safety_checker": true
    },
).json()

# Poll submitted["status_url"] until "COMPLETED", then:
result = requests.get(submitted["response_url"], headers=headers).json()

Input parameters

Input parameters of Seedream V4.5 Text to Image
NameTypeRequiredDescription
promptstringyesThe text prompt used to generate the image
image_sizeenumnoThe size of the generated image. Use a preset string (e.g. '4_3_1k') or a custom {width, height} object. One of: 1_1_512, 1_1_1k, 1_1_2k, 1_1_4k, 16_9_512, 16_9_1k, 16_9_2k, 16_9_4k, 9_16_512, 9_16_1k, 9_16_2k, 9_16_4k, 4_3_512, 4_3_1k, 4_3_2k, 4_3_4k, 3_4_512, 3_4_1k, 3_4_2k, 3_4_4k, 3_2_512, 3_2_1k, 3_2_2k, 3_2_4k, 2_3_512, 2_3_1k, 2_3_2k, 2_3_4k, 4_5_512, 4_5_1k, 4_5_2k, 4_5_4k, 5_4_512, 5_4_1k, 5_4_2k, 5_4_4k, 4_1_512, 4_1_1k, 4_1_2k, 4_1_4k, 1_4_512, 1_4_1k, 1_4_2k, 1_4_4k, 8_1_512, 8_1_1k, 8_1_2k, 8_1_4k, 1_8_512, 1_8_1k, 1_8_2k, 1_8_4k, 21_9_512, 21_9_1k, 21_9_2k, 21_9_4k. Default: "4_3_1k".
enable_safety_checkerbooleannoIf set to true, the safety checker will be enabled. This setting can only be configured via the API. Default: true.
num_imagesintegernoThe number of images to generate. Each generated image is billed. Default: 1.
seedintegernoRandom seed to control the stochasticity of image generation.

Machine-readable: OpenAPI schema · llms.txt

Use Seedream V4.5 Text to Image from Claude & Cursor (MCP)

Point Claude Code, Claude Desktop, Cursor, or any MCP client at the ModelRunner MCP server and Seedream V4.5 Text to Image becomes a tool your assistant can call directly — it authorizes via OAuth (no API key in config) and runs this model with the run_model tool using the endpoint bytedance/seedream-v4.5/text-to-image.

MCP client config (Claude Desktop, Cursor)

{
  "mcpServers": {
    "modelrunner": {
      "command": "npx",
      "args": ["-y", "mcp-remote", "https://mcp.modelrunner.run/mcp"]
    }
  }
}

Claude Code

claude mcp add --transport http modelrunner https://mcp.modelrunner.run/mcp

Then ask your assistant, for example: “Run bytedance/seedream-v4.5/text-to-image on ModelRunner to generate image”. MCP setup guide.

Model Detayları

Model Detayları

Seedream 4.5, ByteDance tarafından geliştirilen son teknoloji bir text-to-image modelidir; betimleyici metin prompt’larından çarpıcı, yüksek sadakatli görseller üretmek için tasarlandı. Gelişmiş ve birleşik bir mimari üzerine kurulduğu için karmaşık talimatları anlamakta çok başarılıdır; içerik üreticileri ayrıntılı sahneleri, kendine özgü görsel stilleri ve hassas kompozisyonları zahmetsizce kurar.

Bu modeli doğrudan uygulama arayüzünden çalıştırabilirsiniz. Betimleyici prompt’unuzu girin, istediğiniz çıktı boyutunu seçin ve ürettiğiniz görselleri arayüzün yerleşik bileşenleriyle güvenle indirin.

**Özellikler** * **İsabetli Metin Basma:** Prompt’taki belirli talimatlara göre, doğrudan görselinizin içine okunaklı ve net görünen tipografi üretir. * **Stil Esnekliği:** Farklı fotoğraf stillerine, belirli kamera açılarına (selfie ya da geniş çekim gibi) ve ince son işlem efektlerine (hareket bulanıklığı ya da aşırı pozlama gibi) pürüzsüzce uyum sağlar. * **Yüksek Çözünürlüklü Çıktı:** Farklı boyutlarda canlı ve ayrıntılı görseller üretebilir; kusursuz kalite için otomatik 2K ve 4K optimizasyonlarını destekler.

**En uygun olduğu işler** * Yoğun biçimde stilize edilmiş, fotogerçekçi ya da hayal gücüne dayalı, ince ayrıntılarla dolu sanatsal görseller üretmek. * Belirli karakter özelliklerini, hareketli ortam kurgularını ve metin yerleşimlerini aynı anda birleştiren karmaşık, çok katmanlı prompt’ları izlemek. * Çok belirli bir çerçeveleme, ışık ya da kendine özgü bir görsel işleyiş gerektiren hareketli sahneler üretmek.

**İpuçları** * Olabildiğince betimleyici olun. Modeli doğru yönlendirmek için ışığı, kamera açılarını, duygusal tonu ve öznenin odağını belirtin. * Üretiminize metin eklerken tam ifadeyi prompt’un içinde tırnak içine alın, yerleşimini ve tipografisini tarif edin (ör. *En üstte net harflerle yazılmış "Hello World" metni*). * Farklı ayrıntılı açıklamaları uygulamanın arayüzünde deneyin; en iyi kompozisyonu bulmak için birden çok varyasyonu kolayca indirin.

ModelRunner JavaScript client ile çalıştırmak için: ```javascript import { modelrunner } from "@modelrunner/client";

const result = await modelrunner.subscribe("bytedance/seedream-v4.5/text-to-image", { input: { prompt: "A selfie of a happy cat at twilight near the Eiffel Tower, holding a piece of baklava. The photo has slight motion blur and is slightly overexposed. The text \"Seedream 4.5\" is clearly written at the top.", image_size: "auto_2K" }, });

console.log(result); ```